普瑞塞斯大人镇楼
一.为何要进行拥塞控制
拥塞是指网络中的负载(发送到网络中的数据包)超过了网络的处理能力(路由器 ,链路等的容量),导致网络性能急剧下降的现象.假想主机A给主机B传输数据,并且目前有太多主机正在使用信道资源,导致网络拥塞了的这么一个情景.A的数据包被拦在半路没有到B,而A一直没有收到B的ACK (Acknowledgement) ,导致A误以为发生丢包,从而重新传输这个数据包,造成网络更加拥堵.为了避免这种正反馈循环,我们要进行拥塞控制.
二.拥塞控制的核心思想与核心变量
TCP拥塞控制的核心思想是:每个发送方都通过观察网络的反馈(主要是数据包丢失)来探测网络的可用带宽,并据此动态调整自己的发送速率. 为了实现这一目标,TCP 为每个连接维护了两个核心变量:
- 1.拥塞窗口(cwnd – Congestion Window):
- 规则: 在途字节数(已经发送但未确认收到) ≤ cwnd. 在慢启动与拥塞避免中,cwnd即为单次传输的最大数据量.
- 2.慢启动阈值(ssthresh – Slow Start Threshold):
- 这是一个阈值,用于决定使用慢启动算法还是拥塞避免算法.这将在下面的算法中详细讲到.
三.TCP拥塞控制主要算法
TCP拥塞控制不是一个单一的算法,而是四个算法的组合,最经典的实现被称为Reno.下面我们来讲解Reno.
慢启动 (slow start)
定义:主机在已建立的TCP连接上开始发送数据时,由于不知道网络当前的负荷情况,可以由小到大逐渐增大拥塞窗口数值.
具体实现方法:
- 初始时,cwnd 被设置为一个很小的值(一般 1 个 MSS – Maximum Segment Size(最大报文段尺寸,简称MSS))
- 发送方每次收到一个新的ACK,cwnd就增加 1 个MSS
- 呈现的结果是一开始时cwnd成指数生长
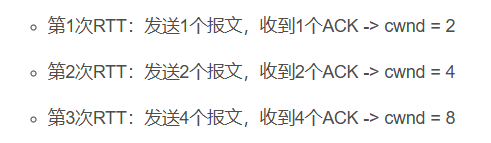
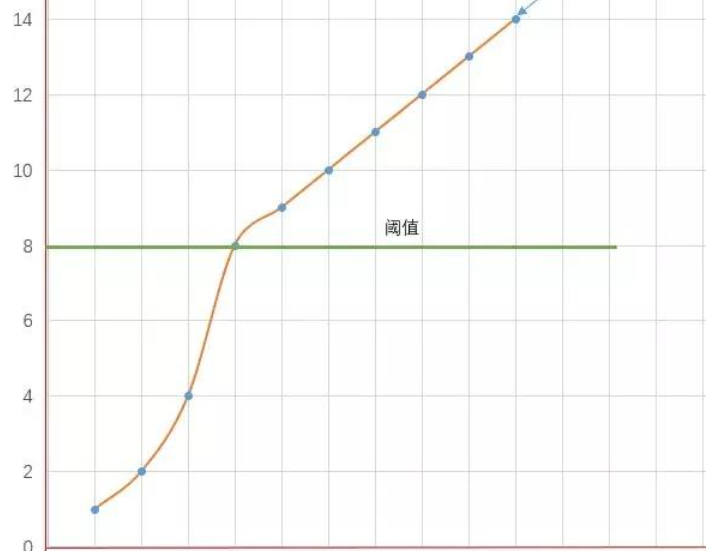
当然这样的指数级增长绝对不是无限制的.当cwnd大于等于ssthresh时,转为拥塞避免阶段.
慢启动让计算机在连接刚开始或从拥塞中恢复时,快速探测网络的可用带宽.
拥塞避免(Congestion Avoidance)
定义:当cwnd大于等于ssthresh时,从指数增长转为线性增长,谨慎地探测更多可用带宽,避免很快再次引发拥塞.
具体实现方法:发送方每次收到一个新的ACK,cwnd就增加 1/cwnd 个MSS.
慢启动与拥塞避免结合起来,呈现的效果图如下:
快速重传(Fast Retransmit)
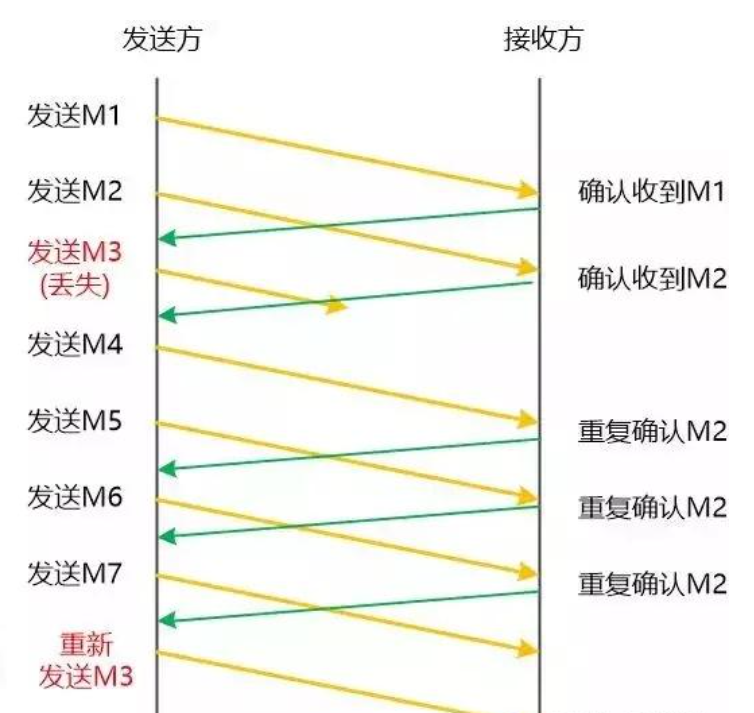
数据包是有序号的.我们构想一个场景,主机A给主机B传输信息.我们都知道,数据包是有序号的,如果A给B发送M1, M2, M3, M4, M5…N个数据包.此时由于不可抗因素,M2在传输过程中丢失.传统的情况下要等到A主机的超时计数器到期,A才会再次传输这个数据包.
快速重传算法下,如果B收到了M1, M2, M4….却始终没有收到M3,这个时候就会重复确认M2,意在告诉A M3还没收到,可能是丢失. 当A连续收到了 三个 确认M2的ACK,且M3超时事件还没发生.A就知道M3可能丢失了,这个时候A就不必等待M3设置的计时器到期了,而是快速重传M3.
快速恢复(Fast Recovery)
Reno在发生快速重传后,快速恢复算法使主机平滑地降低发送速率并恢复,而不是一下子退回到慢启动.(这是Reno与他之前的版本Tahoe的主要区别)
具体实现步骤:
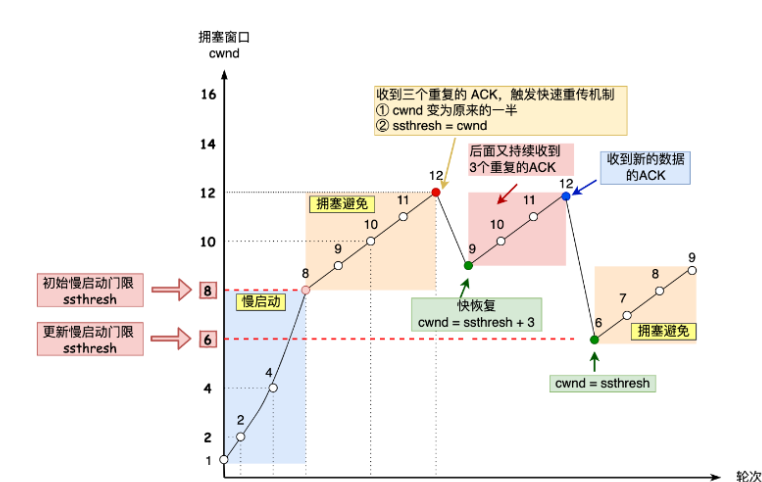
- 当主机A收到三个重复的ACK后,将 ssthresh 设置为 cwnd / 2(至少为 2),并进入快速恢复.
- 快速恢复时,cwnd设置为ssthresh+3(这里因为能收到3个ack代表有三个数据包被确认收到.如果不加3的话,信道资源会被浪费掉,+3(贴吧传统)保证了传输效率)
- 重传数据包
- 收到相同的ack后, cwnd=cwnd+1(这里逐渐+1是因为保证传输效率,主机A未收到这些数据的ack,默认他们还在占用信道,为了避免把信道卡死,cwnd逐渐+1)
- 收到新的ack后,代表所有的堵塞已经结束.tcp此时判断可以开始恢复之前的状态了.此时设置cwnd=ssthresh,进入拥塞避免状态.
四(补充).主动队列管理AQM
上文讲到的tcp拥塞控制更多的是从发送方的角度去进行调控的.我们也可以尝试从接收方去调控,这也就引出了AQM(Application-network Quality Measurement)技术.这通常与上文提到的Reno配合使用.
AQM算法是为了在保证流量高的同时,尽可能减少网络延迟.所谓主动,就是不等路由器队列长度达到最大值时才不得不舍弃后面到的分组,在队列长度出现可能达到拥塞的预兆时,主动丢弃到达的分组.
AQM算法又多种实现方式,这里介绍最基础的实现方式:随机早期检测RED(Random Early Detection)算法.
RED算法有以下特点:
1.队列长度监控:RED算法会持续监控路由器的队列长度(即缓冲区中的数据包数量),这里队列长度本次大作业我们监测的是实时长度,也有的路由器检测的是历史加权平均长度.
2.阈值设置:RED定义了最小阈值与最大阈值.队列长度<最小阈值时,所有数据包都会被接受;队列长度超过最大阈值时,所有数据包都会被舍弃.
3.丢包概率计算:当队列长度位于两个阈值之间时,RED会根据队列长度相对于阈值的位置,以及其他可能的参数(比如丢包率的增长速率),计算出一个丢包概率. 这里我们参考Sally Floyd和Van Jacobson在1993年发表的经典论文《Random Early Detection Gateways for Congestion Avoidance》,来给出丢包概率的计算.
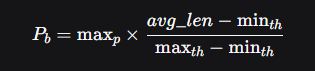
- avg_len:在本次大作业中,用检测的实时长度替代
- maxp:预设的一个最大概率
- min_th 和 max_th:就是两个阈值
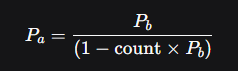
Pa即为最终概率,count是引入的一个计数器,记录自从上次丢包后,已经顺利通过的数据包数量
4.随机丢包或标记:对于每个到达的数据包,RED算法会根据计算出来的丢包概率,随机地决定是否丢弃或标记该数据包。标记通常是指设置数据包头中的ECN(Explicit Congestion Notification)字段,如果发送和接收端都支持ECN,这可以用来通知对方网络拥塞的情况,而不需要实际丢弃数据包
5.对TCP流量的效果:当RED丢弃或标记了一个TCP数据包,TCP的拥塞控制机制会对此做出反应,比如进入拥塞避免阶段或者降低发送窗口,从而减少数据的发送速率,以减轻网络的拥塞
图像来源及文档参考:https://zhuanlan.zhihu.com/p/97709686
评论(1)